Evidently AI 是一个开源的 AI 评估与可观测性框架,目标是让 AI 在上线前达到生产可用的状态。它主要做两件事:测试大语言模型,以及监控 AI 应用在实际运行中的表现。覆盖的对象包括一般的 AI 应用、RAG 检索增强系统和多智能体工作流。官网将其定位为领先的开源 AI 评估框架,社区里有 3000 多名 AI 构建者参与。
AI 系统的失败方式跟传统软件不一样。传统软件挂了会报错,AI 不会。它可能一本正经地给出错误答案,可能在某次更新后回答质量悄悄下滑,也可能在检索环节拿错了资料却没有任何提示。没有测试和监控手段的团队,往往只能靠用户投诉或者抽查来发现问题,等发现时影响已经造成了。官网有句话很直接:你无法信任你没有测试过的东西。Evidently AI 要补的就是这个缺口,让团队在每次更新之前都能确认系统是安全的、可靠的、准备好的,而不是上线之后靠运气。
它最适合的是正在把大语言模型真正推向生产环境的 AI 团队,尤其是那些应用里包含 RAG 检索或者多智能体协作的项目。这类系统的出错环节多,自动化评估和持续监控的价值最明显。如果你只是想快速试一下某个模型、写几段提示词
📬 不错过下一款好工具
每周二、周五各一期,随时退订
这是你的产品?认领并提升曝光 →
实际用起来,整个流程围绕三个核心环节展开。第一个是自动化评估:你带着自己的用例来,比如一个客服问答机器人或者一个文档检索应用,框架帮你系统地测试模型的回答质量,而不是靠人肉抽查几条。第二个是合成数据:当你手头没有足够的测试样本时,可以用它生成数据来补充评估集,让测试覆盖面更广。第三个是持续监控:上线之后持续跟踪对你这个用例来说重要的指标,比如回答是否准确、检索是否命中了正确的内容,一旦出现质量漂移就能发现。从输入到产出,就是接入你的 AI 应用,定义要评估什么,跑评估、看结果,然后把监控挂上,让每次更新都有据可查。
参考资料里没有给出具体的价格档位和金额,价格信息以官网当前公示为准。框架本身是开源的,可以直接从官网获取并开始使用。
选它的场景很明确:你在维护一个已经上线或即将上线的 AI 应用,尤其是 RAG 或多智能体系统,需要在每次更新前做自动化评估,并且上线后持续盯着质量指标。这两种需求它都覆盖。如果你的工作重心在模型训练、数据标注或者提示词的一次性调试上,那应该去看对应类型的工具,评估和观测框架解决不了那些问题。
以官网当前公示为准
Comet ML是面向AI开发者的端到端平台,提供模型训练追踪与LLM应用观测评估能力。
序列猴子是出门问问推出的一款超大规模语言模型及AI工作流编排自动化平台,支持长序列与多模态处理,帮助用户高效串联各类模型,实现复杂任务的无缝衔接与自动化流转。

Coze
文心大模型是百度自主研发的产业级知识增强大语言模型,具备卓越的自然语言理解与多模态生成能力,深度优化中文语境,全面赋能内容创作与企业智能化服务。
OpenBMB是由清华团队发起的大规模预训练语言模型开源库,提供从训练到部署的全流程工具链,降低大模型研发门槛。
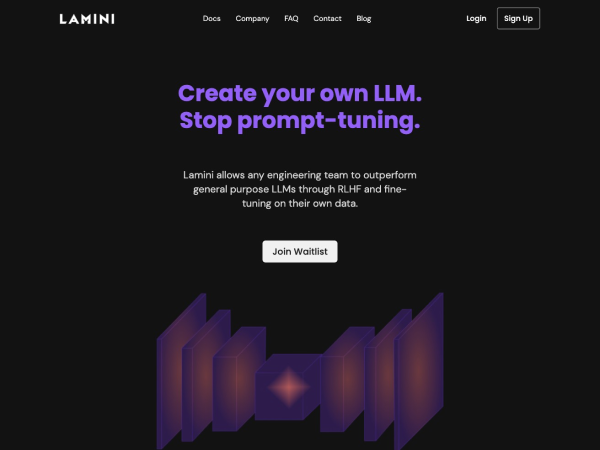
Lamini AI 是一款专为开发者设计的低代码大语言模型定制引擎,通过简化API与自动化基础设施管理,助力企业低门槛、高效率地完成领域专属模型的微调与部署。